

Make hat seine Abrechnungseinheit umbenannt: Was jahrelang Operations hiess, heisst seit Ende August 2026 Credits. Für die meisten Szenarien ändert sich rechnerisch nichts, für AI-Module dagegen schon. Dieser Artikel zeigt, wie die Make.com Preise 2026 aufgebaut sind, was die Umstellung konkret bedeutet und wo die typischen Kostentreiber liegen.
Von Operations zu Credits: was sich geändert hat
Make verkauft keine Software-Lizenzen, sondern Verbrauch. Bis Sommer 2026 hiess die Einheit Operation, inzwischen heisst sie Credit. Die Umstellung erfolgte im Verhältnis 1:1: Aus 10'000 Operations wurden 10'000 Credits, die Planpreise blieben gleich.
Wichtig für die Praxis, weil viele Anleitungen und interne Kalkulationen noch den alten Begriff verwenden:
Der Begriff Operation ist nicht verschwunden: Er bezeichnet weiterhin den einzelnen Modullauf. Nur abgerechnet wird nicht mehr in Operations, sondern in Credits, und diese beiden Grössen sind eben nicht mehr zwingend identisch.
Wo ein Credit mehr als eine Operation kostet
Der praktische Unterschied liegt bei AI. Drei Fälle sind zu unterscheiden:
- Standard-Module (CRM, Sheets, Slack, HTTP, Filter, Router): 1 Credit pro Ausführung, unabhängig von Datenmenge oder Dateigrösse.
- AI-Module mit eigenem Provider-Key (OpenAI, Anthropic und ähnliche, mit eigenem Account angebunden): 1 Credit pro Ausführung. Die Token-Kosten zahlen Sie direkt beim Anbieter, nicht über Make.
- Make-eigene AI-Features und AI Agents: dynamischer Verbrauch. Je nach Modell und Token-Menge kostet ein einziger Aufruf ein Vielfaches eines Credits.
Wer AI-Schritte über Make abrechnet statt über den eigenen Provider-Key, sollte diesen Posten vor dem Produktivgang einmal mit realen Daten messen. Ein Agent, der pro Durchlauf mehrere Tool-Aufrufe macht, verhält sich beim Verbrauch völlig anders als ein klassisches Modul.
Die Plan-Struktur
Stand September 2026, massgeblich ist immer make.com/pricing:
Der Startpreis gilt jeweils für das kleinste Kontingent der Stufe. Das Kontingent lässt sich in jeder Stufe nach oben skalieren, von 10'000 bis in den Bereich mehrerer Millionen Credits pro Monat. Bei jährlicher Zahlung gewährt Make einen Rabatt von rund 15 Prozent.
Mit steigender Plan-Stufe kommen neben mehr Credits auch funktionale Vorteile dazu:
- kürzere Ausführungsintervalle
- mehr gleichzeitige Ausführungen
- priorisierte Rechenzeit
- längere Log-Aufbewahrung
- benutzerdefinierte Variablen und ab Teams eine Rollenverwaltung
Die typischen Kostenfallen
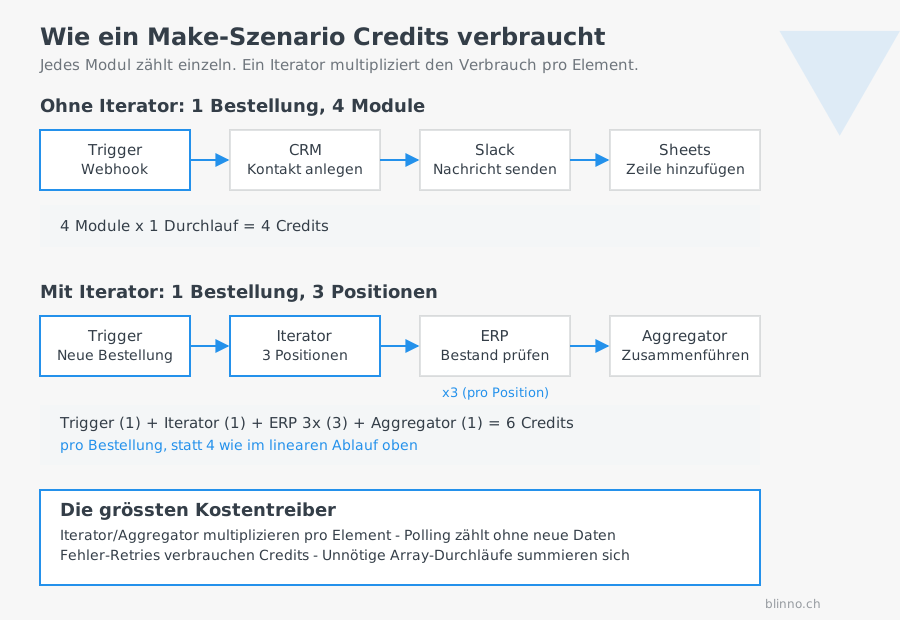
Überraschende Rechnungen entstehen selten durch die Anzahl der Szenarien, sondern durch deren innere Struktur. Fünf Muster tauchen in der Praxis am häufigsten auf.
1. Iterator und Aggregator
Ein Iterator zerlegt ein Array in einzelne Elemente, damit jedes einzeln weiterverarbeitet werden kann, zum Beispiel 50 Zeilen aus einer Excel-Datei. Jedes Element, das danach ein weiteres Modul durchläuft, verbraucht einen eigenen Credit. Ein Szenario, das 50 Zeilen liest und pro Zeile drei Module durchläuft, erzeugt aus einem einzigen Durchlauf schnell 150 Credits oder mehr. Der Aggregator zählt ebenfalls pro Durchlauf.
2. Polling statt Webhook
Viele Integrationen lassen sich per Webhook (die Quelle meldet sich) oder per Polling (Make fragt in festen Intervallen nach) anbinden. Polling verbraucht auch dann, wenn es nichts Neues gibt. Bei einem 5-Minuten-Intervall sind das theoretisch bis zu 288 Abfragen pro Tag und Szenario, unabhängig vom tatsächlichen Datenaufkommen.
3. Fehlerschleifen und Retry-Logik
Ein Szenario ohne sauberes Error Handling, das bei einem Fehler mehrfach neu startet oder in eine Schleife läuft, kann den Verbrauch innerhalb weniger Stunden vervielfachen. Retry-Versuche zählen in der Regel ebenfalls, auch wenn sie am Ende fehlschlagen.
4. Unnötige Array-Verarbeitung
Wird eine Datenstruktur mehrfach durch Iteratoren und Filter geschickt, obwohl eine Aggregation oder ein einzelner Datenbankaufruf gereicht hätte, vervielfacht sich der Verbrauch pro Schritt. Das passiert häufig in Szenarien, die über Jahre gewachsen sind und nie aufgeräumt wurden.
5. AI-Module ohne Messung
Die neue Kostenfalle seit der Credit-Umstellung. Ein AI-Schritt, der über Make abgerechnet wird, hat keinen festen Preis mehr: Je länger Prompt und Antwort, desto mehr Credits. Bei einem Agent, der pro Anfrage mehrere Tool-Aufrufe macht, summiert sich das schnell. Wer AI produktiv einsetzt, sollte den Verbrauch pro Durchlauf messen, bevor das Szenario auf das volle Volumen losgelassen wird.
Zwei Rechenbeispiele aus der Praxis
Die Beispiele sind bewusst einfach gehalten, damit die Rechenlogik nachvollziehbar bleibt. Beide verwenden nur Standard-Module, für die weiterhin 1 Credit pro Ausführung gilt.
Beispiel A: Lead-Weiterleitung aus einem Formular
Ein KMU leitet Leads aus einem Webformular ins CRM weiter, informiert den Vertrieb per Slack und legt einen Tabelleneintrag an.
- Trigger (Webhook, neuer Formulareintrag): 1 Credit
- CRM: Kontakt suchen oder anlegen: 1 Credit
- CRM: Deal erstellen: 1 Credit
- Slack: Nachricht senden: 1 Credit
- Google Sheets: Zeile hinzufügen: 1 Credit
Ein Durchlauf verbraucht 5 Credits. Bei 40 Leads pro Monat sind das 200 Credits, bei 300 Leads 1'500 Credits. Ein webhook-basiertes Szenario wie dieses bleibt selbst bei deutlichem Wachstum im günstigsten bezahlten Kontingent.
Beispiel B: Tägliche Bestandsabgleichung mit Polling und Iterator
Ein anderes KMU gleicht täglich den Lagerbestand aus einem Onlineshop mit einer ERP-Tabelle ab. Das Szenario pollt alle 15 Minuten und verarbeitet pro Bestellung mehrere Positionen einzeln.
- Polling-Trigger alle 15 Minuten, rund um die Uhr: 96 Abfragen pro Tag, auch ohne neue Daten: 96 Credits/Tag
- Bei 20 Bestellungen pro Tag mit je 3 Positionen: Iterator erzeugt 60 Elemente
- Pro Element ERP-Bestand prüfen (1) und aktualisieren (1): 120 Credits/Tag
- Aggregator: 20 Credits/Tag
- Bestellstatus zurück in den Shop schreiben: 20 Credits/Tag
Summe: rund 256 Credits pro Tag, auf 30 Tage etwa 7'680 Credits für dieses eine Szenario. Kommen zwei oder drei ähnlich gebaute Szenarien dazu, wie es in gewachsenen Setups üblich ist, ist das Einstiegskontingent ausgeschöpft, obwohl das eigentliche Geschäftsvolumen mit 20 Bestellungen pro Tag überschaubar bleibt.
Der Vergleich zeigt das Kernproblem: Nicht das Geschäftsvolumen bestimmt die Kosten, sondern die technische Umsetzung des Szenarios.
Fünf Hebel, um den Credit-Verbrauch zu senken
- Webhook statt Polling, wo die Quelle es unterstützt. Eliminiert die permanenten Leerabfragen komplett und ist der wirkungsvollste Einzelhebel im zweiten Beispiel.
- Polling-Intervalle bewusst wählen. Wo kein Webhook verfügbar ist, reicht oft ein 30- oder 60-Minuten-Intervall statt 15 Minuten. Das viertelt den Verbrauch durch das Polling allein.
- Batch-Verarbeitung statt Einzel-Iteration prüfen. Manche Zielsysteme bieten Bulk-Endpunkte, mit denen mehrere Datensätze in einem Modul-Aufruf verarbeitet werden.
- Filter so früh wie möglich setzen. Direkt nach dem Trigger, nicht erst nach mehreren verarbeitenden Modulen, die sonst für irrelevante Datensätze mitlaufen.
- AI über den eigenen Provider-Key anbinden. Wer OpenAI oder Anthropic mit eigenem Account einbindet, zahlt in Make nur einen Credit pro Aufruf und die Token-Kosten transparent beim Anbieter, statt beides vermischt über das Credit-Kontingent.
In der Kombination lassen sich damit in vielen bestehenden Szenarien 30 bis 50 Prozent einsparen, ohne dass sich am Ergebnis für den Endnutzer etwas ändert.
Wo sich ein Audit lohnt
Ein Szenario-Audit lohnt sich, wenn der Credit-Verbrauch schneller wächst als das Geschäftsvolumen, wenn ein Upgrade in die nächste Plan-Stufe ansteht, ohne dass klar ist, ob es nötig ist, oder wenn AI-Module produktiv gehen sollen und der Verbrauch noch nicht gemessen wurde. In der Praxis reichen oft zwei oder drei strukturelle Anpassungen, um im aktuellen Plan zu bleiben.
✨ AI generated content


