

Ein Make-Szenario, das seit Monaten fehlerfrei läuft, kann jederzeit an einer einzigen Stelle scheitern, ohne dass jemand es bemerkt. Ohne Error Handler stoppt Make die Ausführung einfach und wartet auf den nächsten Trigger. Dieser Artikel zeigt, wie du mit Directives, Retry-Strategien und Alerting Szenarien baust, die produktionstauglich sind.
Was passiert ohne Error Handler
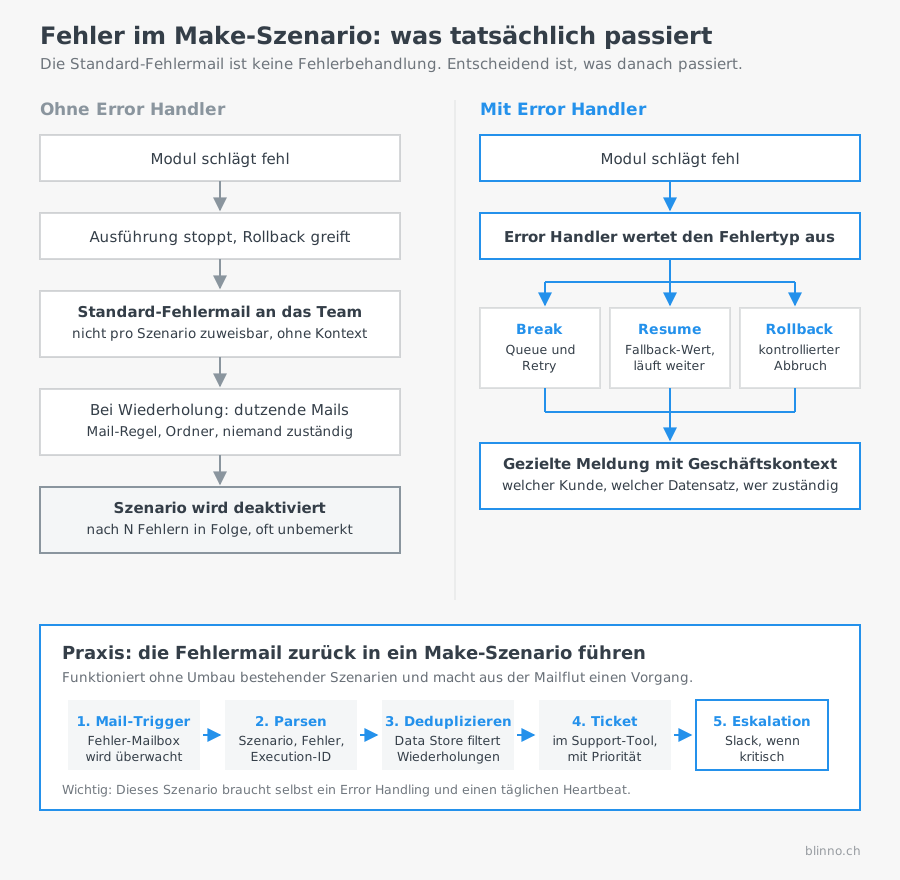
Schlägt ein Modul fehl und es existiert keine Fehlerroute, wird die Ausführung sofort abgebrochen. Standardmässig greift dabei implizit die Directive Rollback: Bereits committete Schritte werden zurückgerollt, die Ausführung wird als fehlgeschlagen markiert.
Make lässt dich damit nicht völlig im Dunkeln, es verschickt eine automatische Fehlermail. Genau hier liegt aber das eigentliche Problem, und es ist in der Praxis grösser als die fehlende Benachrichtigung selbst.
Warum die Standard-Fehlermail nicht reicht
Die automatische Benachrichtigung von Make ist nicht granular steuerbar. Sie lässt sich nicht pro Szenario einer bestimmten Person zuweisen, und je nach Team-Konstellation landen die Mails bei mehreren Personen gleichzeitig. Das Ergebnis kennt jedes Team, das eine Weile mit Make arbeitet:
- Bei einem Fehler, der sich mehrfach wiederholt, kommen dutzende gleichartige Mails.
- Niemand ist formal zuständig, also fühlt sich niemand zuständig.
- Nach zwei Wochen existiert eine Mail-Regel, die diese Absenderadresse in einen Ordner verschiebt. Ab da ist der Fehler faktisch unsichtbar.
- Die Mail enthält keinen Geschäftskontext: Sie sagt, welches Szenario gestoppt hat, aber nicht, welcher Kunde, welche Bestellung oder welcher Datensatz betroffen ist.
Dazu kommt ein zweiter Mechanismus: In den Szenario-Einstellungen legt „Number of consecutive errors“ fest, nach wie vielen aufeinanderfolgenden Fehlern Make das Szenario automatisch deaktiviert. Passiert das unbemerkt, läuft der Prozess tagelang gar nicht mehr, und das fällt erst auf, wenn ein Mensch die fehlenden Daten vermisst.
Die richtige Konsequenz ist deshalb nicht, noch mehr Benachrichtigungen einzuschalten, sondern festzulegen, was bei einem Fehler passieren soll: welcher Fehlertyp wie behandelt wird, wo der Fall landet und wer ihn bearbeitet.
Die fünf Error-Handler-Directives
Ein Error Handler wird an ein Modul angehängt (Rechtsklick, „Add error handler“) und definiert eine eigene Fehlerroute. Am Ende dieser Route legt eine Directive fest, wie sich die Gesamtausführung verhält.
Als Faustregel gilt: Break für alles, was mit erneutem Versuch wahrscheinlich funktioniert; Resume oder Ignore für optionale, nicht kritische Schritte; Rollback oder Commit für alles, wo die Konsistenz der committeten Daten im Vordergrund steht.
Incomplete Executions und automatische Retries
Nutzt ein Modul die Directive Break, landet die fehlgeschlagene Ausführung in „Monitoring → Incomplete Executions“. Für die dort typischen Fehlerarten (Rate Limit, Connection-Fehler, Modul-Timeout) versucht Make automatisch, die Ausführung erneut zu starten, mit exponentiell wachsenden Abständen: nach 1 Minute, dann 10, 10, 30 Minuten und weiter bis zu 3-Stunden-Intervallen. Pro Szenario laufen dabei maximal drei Incomplete-Execution-Retries parallel, um zu verhindern, dass ein Retry-Sturm selbst neue Rate-Limit-Fehler auslöst.
Für Fehler, die über einen expliziten Error Handler mit Break-Directive behandelt werden, lassen sich Anzahl der Wiederholungsversuche (1 bis 10) und das Intervall zwischen den Versuchen (in Minuten, fix statt exponentiell) selbst konfigurieren. Die Warteschlange zeigt dabei das fehlgeschlagene Modul, die Fehlermeldung, die Bundle-Daten und die Anzahl bisheriger Versuche an. Einträge lassen sich manuell erneut auslösen, vor dem erneuten Versuch bearbeiten oder löschen. Wie lange Einträge aufbewahrt werden, hängt vom Plan ab, auf dem kostenlosen Plan kürzer als auf bezahlten Plänen.
Monitoring und Alerting aufsetzen
Ein Error Handler allein löst das Sichtbarkeitsproblem nicht. Erst eine aktive Benachrichtigung macht Fehler zu etwas, das du tatsächlich siehst.
Fehlerroute mit Slack- oder E-Mail-Benachrichtigung
Füge an kritischen Modulen einen Error Handler hinzu und leite innerhalb der Fehlerroute eine Nachricht an Slack oder per E-Mail weiter. Nutze dabei die eingebauten Fehlervariablen:
{{error.message}}: menschlich lesbare Fehlerbeschreibung{{error.type}}: Fehlerkategorie, etwa RuntimeError{{error.subtype}}: konkreter Fehlercode, etwa RateLimitError oder NotFound
So siehst du sofort, welches Modul in welchem Szenario mit welcher Ursache gescheitert ist, statt das Execution-Log manuell durchsuchen zu müssen.
Fehlermails in ein Make-Szenario zurückführen
Ein Ansatz, den wir bei Blinno selbst einsetzen und der ohne Umbau bestehender Szenarien funktioniert: Die Standard-Fehlermails von Make werden per Weiterleitungsregel an eine dedizierte Mailadresse geschickt, die als Trigger eines eigenen Make-Szenarios dient. Dieses Szenario übernimmt dann die Arbeit, die sonst ein Mensch im Posteingang machen müsste.
- Mail-Trigger: Ein Watch-Emails-Modul überwacht die Fehler-Mailbox, alternativ ein Gmail- oder Outlook-Modul mit passendem Filter.
- Parsen: Aus Betreff und Body werden Szenario-Name, Team und Fehlermeldung mit Text-Funktionen oder einem regulären Ausdruck extrahiert.
- Anreichern: Über die Make API lässt sich die zugehörige Execution nachladen, um den betroffenen Datensatz zu identifizieren.
- Deduplizieren: Ein Data Store hält fest, welcher Fehler zu welchem Szenario in den letzten Minuten schon gemeldet wurde. Zwanzig identische Mails erzeugen so ein Ticket statt zwanzig.
- Ticket erstellen: Der Fall wird automatisch im Support-Tool angelegt, mit Szenario-Name, Fehlermeldung, Zeitstempel und zuständigem Team. In unserem Fall inklusive Priorität, abgeleitet aus der Kritikalität des betroffenen Szenarios.
- Eskalieren: Bei geschäftskritischen Szenarien geht zusätzlich eine Slack-Nachricht in den zuständigen Kanal, statt nur ein Ticket zu erzeugen.
Der Effekt in der Praxis: Aus einer Mailflut, die jeder ignoriert, wird ein einzelner Vorgang mit klarem Verantwortlichen und Bearbeitungsstatus. Die Reaktionszeit sinkt von „irgendwann, wenn es jemand merkt“ auf Minuten, und es gibt eine Historie, aus der sich erkennen lässt, welche Szenarien regelmässig Probleme machen.
Zwei Hinweise dazu, weil sie regelmässig übersehen werden: Das Alerting-Szenario selbst braucht ebenfalls ein Error Handling, sonst fällt ausgerechnet der Wachhund still aus. Und es sollte auf einem separaten Weg überwacht werden, zum Beispiel über einen Heartbeat, der täglich eine Lebensmeldung sendet.
Eigenes Monitoring-Szenario
Für einen Überblick über mehrere Szenarien hinweg lohnt sich ein separates, zeitgesteuertes Szenario, das täglich über die Make-API die Liste der Incomplete Executions abruft und als Zusammenfassung per E-Mail verschickt. So bleiben auch Fehler sichtbar, die zwar automatisch wiederholt werden, aber wiederholt fehlschlagen.
Router für unterschiedliche Fehlerarten
Innerhalb einer Fehlerroute lässt sich mit einem Router unterscheiden: Ein 429-Fehler (Rate Limit) erhält eine längere Wartezeit vor dem nächsten Versuch, während ein 500-Fehler sofort eine Benachrichtigung auslöst, da er auf ein grundsätzlicheres Problem hindeutet.
Typische stille Fehler in der Praxis
Bestimmte Fehlerquellen zeigen sich nicht sofort, sondern schleichend:
- Webhook-Queue läuft voll: Bei sehr hohem eingehendem Volumen und einem inaktiven oder pausierten Szenario können Webhook-Anfragen in der Warteschlange stecken bleiben oder verloren gehen, wenn die Kapazität überschritten wird.
- Abgelaufene oder widerrufene Connection: Läuft ein OAuth-Token ab oder wird eine Verbindung serverseitig widerrufen, schlagen alle Module fehl, die diese Connection nutzen, oft für mehrere Szenarien gleichzeitig.
- API-Änderung beim Drittanbieter: Ändert ein Anbieter Feldnamen, Antwortstruktur oder Authentifizierungsmethode, kann ein Modul plötzlich falsche oder leere Daten liefern, ohne einen klassischen Fehler zu werfen.
- Datentyp-Mismatch: Erwartet ein nachgelagertes Modul eine Zahl und erhält einen Text (oder umgekehrt, etwa durch eine geänderte Spaltenkonfiguration in der Quelle), kann die Ausführung fehlschlagen oder, schlimmer, mit falschen Werten weiterlaufen.
Diese Fälle zeigen: Error Handling ist nicht einmalig eingerichtet und dann erledigt, sondern muss mit den angebundenen Systemen mitwachsen.
Checkliste für produktionsreife Szenarien
- Jeder externe API-Aufruf hat entweder einen Error Handler mit Break-Directive und Retry oder eine bewusst gewählte andere Directive.
- Kritische Pfade lösen bei einem Fehler eine Slack- oder E-Mail-Benachrichtigung mit
{{error.message}}aus. - Optionale oder ergänzende Module nutzen Resume oder Ignore, damit ihr Ausfall die Kernlogik nicht blockiert.
- Es existiert ein Monitoring-Szenario, das die Incomplete Executions über alle produktiven Szenarien hinweg zusammenfasst.
- Fehlerszenarien wurden bewusst getestet, zum Beispiel durch eine absichtlich ungültige Eingabe.
- Connections werden periodisch überprüft, bevor sie ablaufen oder von einem Anbieter widerrufen werden.
Praxisbeispiel: Rechenlogik für Retry-Intervalle
Ein Szenario verarbeitet eingehende Bestellungen über eine externe Versand-API, die gelegentlich mit Rate-Limit-Fehlern antwortet. Mit Break und einer konfigurierten Retry-Anzahl von 5 sowie einem Intervall von 10 Minuten ergibt sich eine maximale Wartezeit von 50 Minuten, bis eine Bestellung endgültig als fehlgeschlagen markiert wird. Bleibt sie danach immer noch in den Incomplete Executions, greift das tägliche Monitoring-Szenario und meldet den offenen Fall. So bleibt genug Zeit für kurzfristige API-Ausfälle, ohne dass eine Bestellung tagelang unbemerkt hängen bleibt.
✨ AI generated content


