
Ein einzelner Prompt an ein Sprachmodell ist kein AI Agent, auch wenn viele Anbieter das so verkaufen. Ein echter n8n AI Agent trifft Entscheidungen, ruft Tools auf und arbeitet mit Kontext. Dieser Artikel zeigt, welche Nodes dafür notwendig sind, wie ein produktives Praxisbeispiel aussieht und wo die Grenzen liegen.
Prompt-Chain vs. echter Agent
Eine Prompt-Chain ist ein fester Ablauf: Node A generiert Text, Node B formatiert ihn, Node C verschickt ihn. Der Ablauf ist immer derselbe, unabhängig vom Inhalt.
Ein Agent unterscheidet sich in drei Punkten:
- Tool-Aufrufe: Der Agent entscheidet selbst, ob und welches Tool er braucht, zum Beispiel eine Datenbankabfrage oder einen HTTP Request an ein CRM.
- Memory: Der Agent kennt den bisherigen Gesprächsverlauf innerhalb einer Session und kann darauf referenzieren.
- Entscheidungen: Der Agent wählt basierend auf der Anfrage einen von mehreren möglichen Pfaden, statt einen starren Ablauf abzuarbeiten.
Für viele Anwendungsfälle reicht eine Prompt-Chain vollkommen aus, sie ist günstiger, vorhersehbarer und einfacher zu debuggen. Ein Agent lohnt sich dort, wo die Anzahl möglicher Situationen zu gross ist, um sie im Voraus zu verzweigen.
Die relevanten Nodes in n8n
n8n bietet für den Aufbau von Agents eine Reihe von LangChain-basierten Nodes:
Der AI Agent Node implementiert das Tool-Calling-Interface von LangChain: Er beschreibt jedem Tool sein Schema und entscheidet zur Laufzeit, welches Tool für die jeweilige Aufgabe passt. Tools lassen sich frei kombinieren, von einfachen Rechenoperationen über Vector-Store-Abfragen für Wissensdatenbanken bis zu eigenen n8n-Sub-Workflows als Tool.
Wichtig: Die n8n-Memory ist standardmässig session-gebunden. Wer Kontext über mehrere Sessions oder Tage hinweg braucht, muss das explizit mit einer externen Datenbank (z. B. Postgres oder Redis) lösen.
Praxisbeispiel: Support-Mail-Agent
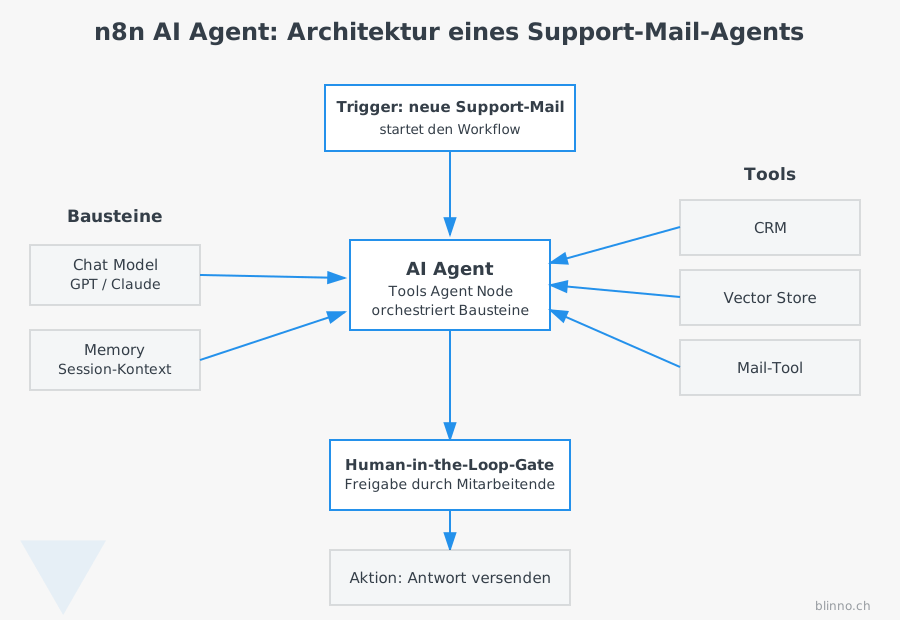
Ein realistischer, produktionstauglicher Aufbau für einen Kundensupport-Anwendungsfall:
- Mail-Trigger: Neue Anfrage im Support-Postfach kommt an.
- Klassifikation: Ein erster AI-Schritt ordnet die Anfrage einer Kategorie zu (z. B. Rechnung, technisches Problem, allgemeine Frage).
- Wissensabruf aus Vector Store: Der Agent durchsucht eine Wissensdatenbank (z. B. bisherige Tickets, Produktdokumentation) nach relevantem Kontext.
- Antwortentwurf: Der Agent formuliert basierend auf Anfrage und Kontext eine Antwort.
- Freigabe durch Mensch: Der Entwurf geht an eine mitarbeitende Person zur Prüfung, z. B. per Slack-Nachricht mit Freigabe-Button.
- Versand: Nach Freigabe wird die Mail automatisch verschickt, bei Ablehnung geht sie zur Überarbeitung zurück an den Agent oder an einen Menschen.
Dieser Aufbau kombiniert die Stärken eines Agents (Kontextverständnis, Tool-Nutzung) mit der Kontrolle, die im Kundenkontakt notwendig ist.
Human-in-the-Loop als Pflicht
Bei allem, was nach aussen wirkt oder Geld bewegt, gilt: kein automatischer Versand ohne Freigabe. Das betrifft Kundenantworten, Rechnungsfreigaben, Vertragsänderungen und ähnliche Aktionen. n8n bietet dafür mehrere Bausteine an, etwa Wait-Nodes mit Freigabe-Webhook oder die Anbindung an Slack- und Teams-Approval-Flows.
Der Grund ist einfach: Ein Sprachmodell kann plausibel formulieren, ohne dass der Inhalt korrekt ist. Ein Mensch als letzte Instanz reduziert dieses Risiko auf ein vertretbares Mass, ohne den Automatisierungsvorteil zu verlieren, denn die Vorarbeit erledigt weiterhin der Agent.
Kostenkontrolle: Token, Modellwahl, Caching
AI Agents verursachen laufende Kosten pro Modellaufruf, unabhängig von n8n selbst. Drei Hebel wirken direkt auf die Rechnung:
- Modellwahl: Nicht jede Aufgabe braucht das teuerste verfügbare Modell. Für Klassifikation oder einfache Extraktion reichen oft günstigere Modelle, das teure Modell bleibt für die eigentliche Textgenerierung reserviert.
- Token-Verbrauch: Lange System-Prompts und grosse Kontextfenster kosten bei jedem Aufruf mit. Wissensabrufe sollten gezielt nur die relevanten Abschnitte liefern, nicht ganze Dokumente.
- Caching: Wiederkehrende Anfragen oder Zwischenergebnisse lassen sich zwischenspeichern, statt bei jedem Durchlauf neu zu berechnen.
Ohne diese drei Punkte im Blick kann ein Agent-Workflow bei steigendem Volumen deutlich teurer werden als geplant.
Wo Agents brechen
Ein ehrlicher Blick auf die Grenzen gehört zu jedem Agent-Projekt dazu:
- Halluzination: Das Modell erfindet Fakten, die plausibel klingen, aber falsch sind, besonders bei fehlendem oder unklarem Kontext.
- Rate Limits: Bei hohem Volumen greifen API-Limits der Modellanbieter, der Workflow muss das abfangen können.
- Endlosschleifen: Ein Agent kann sich bei mehrdeutigen Aufgaben in wiederholten Tool-Aufrufen verfangen, wenn kein Iterationslimit gesetzt ist.
- Kontextlimits: Lange Gesprächsverläufe oder grosse Dokumente sprengen irgendwann das Kontextfenster des Modells.
- Wartung bei Modellwechsel: Wechselt der Anbieter das zugrunde liegende Modell oder ändert Preise und Verhalten, muss der Workflow neu getestet werden.
Diese Punkte sind kein Grund, auf Agents zu verzichten, aber ein Grund, sie nicht ungetestet in kritische Prozesse einzubauen.
Praxisbeispiel: Kostenrechnung
Ein Support-Mail-Agent mit 500 Anfragen pro Monat und durchschnittlich 1'500 Token pro Anfrage (Klassifikation, Wissensabruf und Antwortentwurf zusammen) verursacht je nach Modellwahl unterschiedliche Kosten. Mit einem günstigeren Modell für die Klassifikation und einem leistungsfähigeren Modell nur für die Antwortformulierung lassen sich die Gesamtkosten oft um 30 bis 50 Prozent gegenüber der durchgängigen Nutzung des teuersten Modells senken. Die genauen Preise hängen vom gewählten Modellanbieter ab und sollten vor dem Rollout mit aktuellen Preislisten durchgerechnet werden.
✨ AI generated content